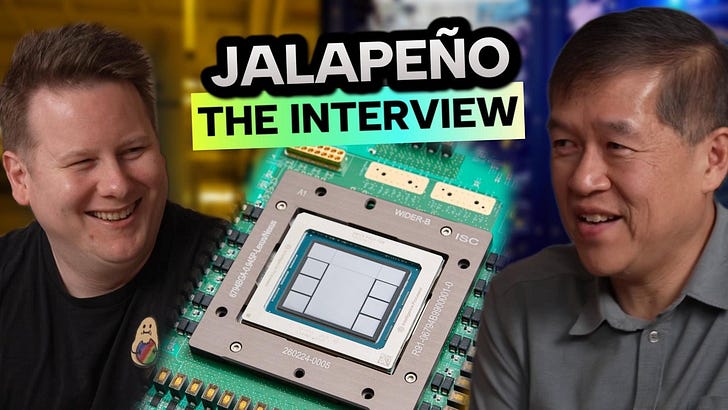
انتقلت Jalapeño، شريحة الاستدلال المخصصة من OpenAI، من مرحلة التأكيد إلى السيليكون المقاس فعليًا. وفي حوار مع الدكتور Ian Cutress من قناة More Than Moore، كشف Richard Ho، نائب رئيس قسم الأجهزة في OpenAI، تفاصيل القطعة التي تبنيها الشركة بالتعاون مع Broadcom كشريك في التصميم، مع تولّي Celestica دمج اللوحات والخزائن.
تأتي هذه المقابلة بعد عرض Ho في مؤتمر HotChips 2026، حيث استعرض أول أداء مقاس من شريحة Jalapeño العاملة إلى جانب Ravi Narayanaswami وChris Leary. والادعاء الأبرز: أن أجهزة OpenAI أسرع وأكثر كفاءة من GB200 وGB300 من NVIDIA في الاستدلال، وأن الشركة استخدمت نماذجها الخاصة للذكاء الاصطناعي للمساعدة في تصميمها.
مواصفات OpenAI Jalapeño وتصميمها
Jalapeño مسرّع للاستدلال وليس شريحة تدريب. وهي تحمل 216 GiB من ذاكرة HBM4 تعمل بسرعة 15.4 TB/s، مقترنة بقاعدة حوسبة وشريحة إدخال وإخراج. وتُقدَّر قدرة الشريحة بـ 700 واط في الذروة، بينما يبلغ الاستهلاك المستمر المقاس نحو 550 واط.
توسّع OpenAI هذه القطعة على مرحلتين: نطاق محلي من 128 مسرّعًا، ونظام كامل من 2,048 مسرّعًا. وعند دقة أربع بتات، يصل النظام الكامل إلى 27 EFLOP/s.
برز قراران تصميميان في HotChips. الأول أن OpenAI بنت قطعة واحدة متوازنة لكامل عبء الاستدلال، بينما تقسّم معظم الشركات مرحلة التعبئة المسبقة والتفكيك الاستباقي والتفكيك الكامل على أجهزة متخصصة. والثاني أن نماذج OpenAI نفسها أسهمت بشكل كبير في التصميم، من عمل الحوسبة وملاءمة الدوائر في المساحة المتاحة إلى تحسين النوى بعد التصنيع لتناسب العتاد.
- النوع: مسرّع استدلال (وليس تدريب)
- الذاكرة: 216 GiB من HBM4 بسرعة 15.4 TB/s
- القواعد: قاعدة حوسبة وشريحة إدخال وإخراج