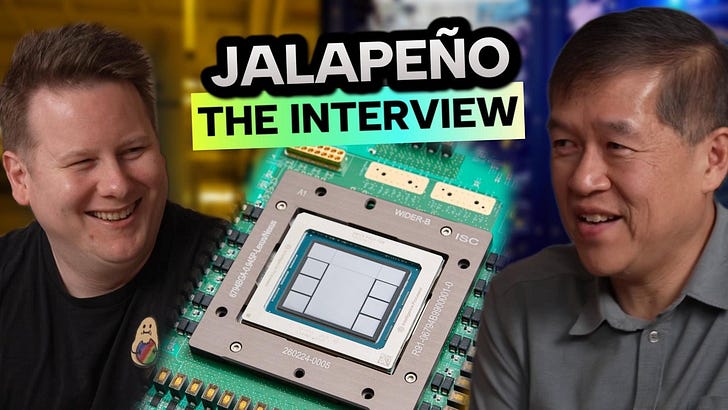
La puce d'inférence maison d'OpenAI, Jalapeño, est passée de la simple confirmation à un silicium réellement mesuré. Dans un entretien avec le Dr Ian Cutress de More Than Moore, Richard Ho, vice-président du matériel chez OpenAI, a détaillé la pièce que l'entreprise développe avec Broadcom comme partenaire de conception, Celestica prenant en charge l'intégration des cartes et des baies.
Cet entretien fait suite à la présentation de Richard Ho à HotChips 2026, où il a dévoilé les premiers chiffres de performance mesurés sur un silicium Jalapeño fonctionnel, aux côtés de Ravi Narayanaswami et Chris Leary. L'affirmation phare : le matériel d'OpenAI serait plus rapide et plus efficace que les GB200 et GB300 de NVIDIA en inférence, et l'entreprise a utilisé ses propres modèles d'IA pour contribuer à sa conception.
Fiche technique et conception de l'OpenAI Jalapeño
Jalapeño est un accélérateur d'inférence, pas une puce d'entraînement. Il embarque 216 GiB de HBM4 cadencée à 15.4 TB/s, associée à une puce de calcul et à un chiplet d'entrées-sorties. La puissance de la puce est annoncée à 700 W en pointe, avec une consommation soutenue mesurée plus proche de 550 W.
OpenAI déploie cette pièce en deux étapes : un domaine local de 128 accélérateurs, et un système complet de 2 048 accélérateurs. En précision quatre bits, ce système complet atteint 27 EFLOP/s.
Deux choix de conception ont marqué HotChips. D'abord, OpenAI a conçu une pièce unique et équilibrée pour l'ensemble de la charge d'inférence, alors que la plupart des fabricants répartissent le prefill, le décodage spéculatif et le décodage complet sur du matériel spécialisé. Ensuite, les propres modèles d'OpenAI ont largement contribué à la conception, du travail de calcul à l'ajustement des circuits dans l'espace disponible, jusqu'à l'optimisation des noyaux après coup pour le matériel.
- Type : accélérateur d'inférence (pas d'entraînement)